엔비디아는 2026년 11월 16일 Nemotron for Science를 발표하며 과학 연구용 모델·화학 데이터셋·후속학습 방법을 함께 소개했습니다. 연구자가 살펴볼 핵심은 완성된 실험 결과보다 자기 연구에 맞게 모델을 조정할 자원과 절차입니다.
핵심 요약
- 공개 대상: 과학 연구에 활용할 모델과 화학 데이터셋
- 활용 방향: 실험 기록을 평가 기준으로 삼는 후속학습
- 판단의 한계: 회사의 활용 사례와 실제 연구 성과를 구분
이 글은 공개된 자료를 바탕으로 작성한 일반 정보이며, 개인의 재무상황이나 투자목적을 고려한 투자자문이 아닙니다. 특정 종목의 매수·매도를 권유하거나 수익을 보장하지 않습니다. 투자에는 원금 손실 위험이 있으며, 투자 판단과 그 결과는 투자자 본인에게 귀속됩니다. 자료는 표시된 기준일 이후 달라질 수 있으므로 투자 전 최신 공시와 원문을 확인하시기 바랍니다.
무엇을 공개했고 어디서 받을 수 있나요?
회사 발표에 따르면 Nemotron 3.5 Super VL 모델과 LitmusBench v0.2 화학 데이터셋은 Hugging Face에서 이용할 수 있습니다. 공식 발표의 Availability 항목에서 공개 대상을 확인할 수 있습니다. 연구자는 모델과 데이터, 학습 방법을 각각 나눠 살펴보는 편이 좋습니다.
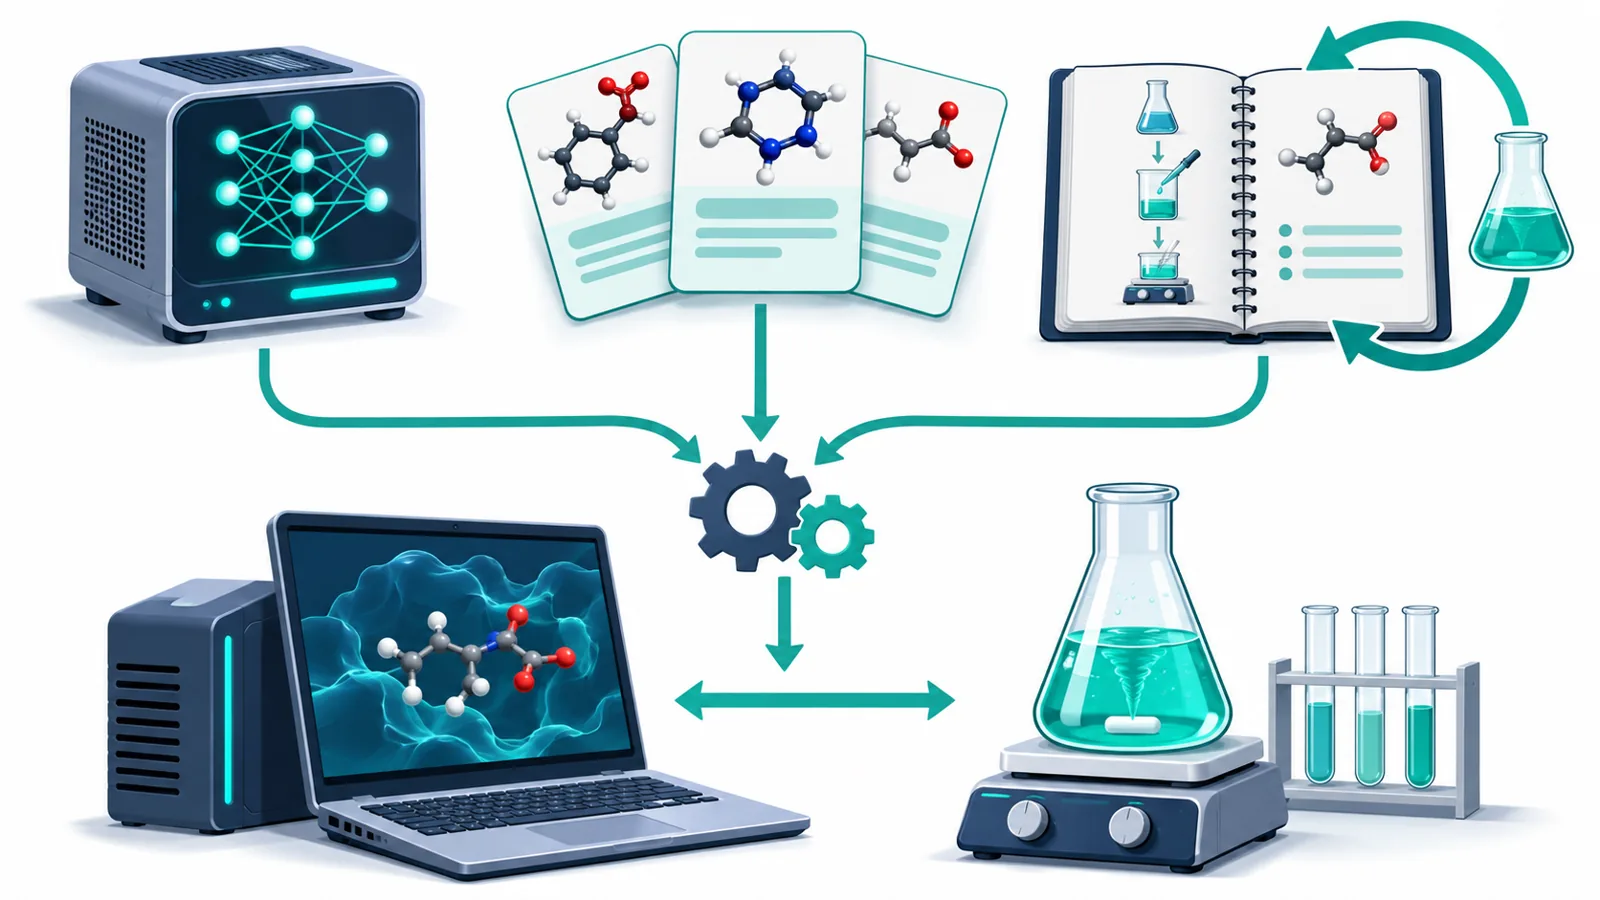
엔비디아는 LitmusBench v0.2를 화학 추론 모델의 학습과 평가에 쓰는 약 5만 개 질문의 공개 데이터셋으로 설명했습니다. NVIDIA 데이터셋 저장소에서는 질문, 기대 답, 분자 속성 등 실제 레코드의 구성을 살펴보세요. 받기 전에 데이터 출처와 라이선스, 연구 목적에 맞는 평가 항목을 먼저 대조하는 순서를 권합니다.
기술 블로그 본문은 데이터셋을 Litmus-Bench V2.0으로 부르지만, 보도자료와 연결된 실제 저장소 이름은 v0.2입니다. 버전 이름을 임의로 같은 것으로 바꾸지 말고, 재현할 때에는 저장소의 파일 버전까지 기록하세요. 이 글은 공개 여부와 제시된 사용 경로를 다루며, 모델을 실행한 결과를 제시하지 않습니다.
연구 데이터는 모델 학습에 어떻게 쓰이나요?
기술 블로그는 실험 데이터로 NeMo Gym의 강화학습 환경을 만들고 NeMo RL로 후속학습하는 방법을 제시합니다. 후속학습 기술 블로그의 출발점은 기존 실험 기록입니다. 모델이 답을 내도록 한 뒤 무엇을 정답으로 채점할지 설계하는 부분에 주목하세요.
약물 대사 예시에서는 출발 분자와 효소를 입력받아 대사산물을 예측하고, 예측 분자와 기준 분자의 지문 유사도로 답을 평가합니다. 이 예시를 읽을 때는 입력 자료, 예측 대상, 채점 기준을 따로 적어보면 이해하기 쉽습니다. 특히 분자 구조의 유사성 평가를 실제 실험 성공이나 치료 효과와 같은 의미로 읽지 않도록 주의해야 합니다.
기술 블로그는 강화학습 전에 더 강한 모델의 추론 예시를 활용하는 선택적 증류 단계도 설명합니다. 독자는 직접 강화학습 경로와 증류를 먼저 거치는 경로를 구분해 읽으면 됩니다. 방법을 도입할지는 자기 데이터에서 정답을 정의할 수 있는지, 평가용 자료를 어떻게 분리할지부터 검토하세요.
확인 순서: 공개 모델·데이터의 버전을 기록하고, 실험 기록의 입력과 정답을 정리한 다음, 평가 기준이 연구 목표와 맞는지 점검하세요. 예제 코드를 읽는 것과 같은 결과를 재현하는 것은 구분해야 합니다.
활용 사례를 어디까지 받아들여야 하나요?
보도자료는 Terray의 화학 반응 정보 추출, Lila Sciences의 실험 프로토콜 설계, Argonne의 단백질 기반 치료 후보 연구를 활용 사례로 소개합니다. 회사 발표의 활용 사례로 귀속해 읽어야 합니다. 서로 다른 연구 작업을 하나의 공통 정확도나 일반적인 비용 절감률로 합쳐 해석하지 않는 것이 적절합니다.
이번 발표의 의미는 연구자가 확인할 모델·데이터·학습 절차가 함께 제시됐다는 데 두겠습니다. 공개 자원의 존재만으로 신약 개발의 성공, 상용 매출 확대나 주가 효과까지 결론 내리지는 않겠습니다. 성능을 판단하려면 관심 작업의 평가 자료와 실패 사례를 추가로 확인해야 합니다.
하드웨어 배경은 기존 GPU 로드맵과 HBM 해설을 참고할 수 있습니다. 여기서는 소프트웨어 공개 범위에 집중하세요. 후속 확인도 막연한 기대보다 모델 카드, 데이터셋 파일, 기술 블로그의 평가 기준 순으로 진행하는 편을 권합니다.
바로 완성된 과학 에이전트를 받는다는 뜻인가요?
공개 모델·데이터와 후속학습 방법을 구분해서 보세요. 자기 연구에 필요한 도구와 평가 기준은 별도로 검토해야 합니다.
발표된 성능 수치를 모든 연구에 적용해도 되나요?
각 사례의 작업과 채점 기준을 먼저 확인하세요. 다른 연구 분야에서도 같은 성과가 나온다고 전제해서는 안 됩니다.